
你有没有试过给朋友讲一道物理题,逻辑清晰、图都画对了,结果让他自己上手搭个斜面小车实验,螺丝拧歪、滑轮卡死、小车直接飞出轨道?大模型现在就卡在这个尴尬点上。VA-Bench一测,真相扎心:Qwen3.8-max这类顶流模型,目标识别率100%,操作语义理解99.6%,可真让机械臂干活——单臂任务成功率还能撑到65%,双臂一上,直接断崖跌到11.11%。不是它看不懂‘左手托瓶、右手旋盖’,是它算不出左手该抬高3.2毫米还是3.7毫米,更不敢在夹爪离瓶口还有4mm时果断闭合。
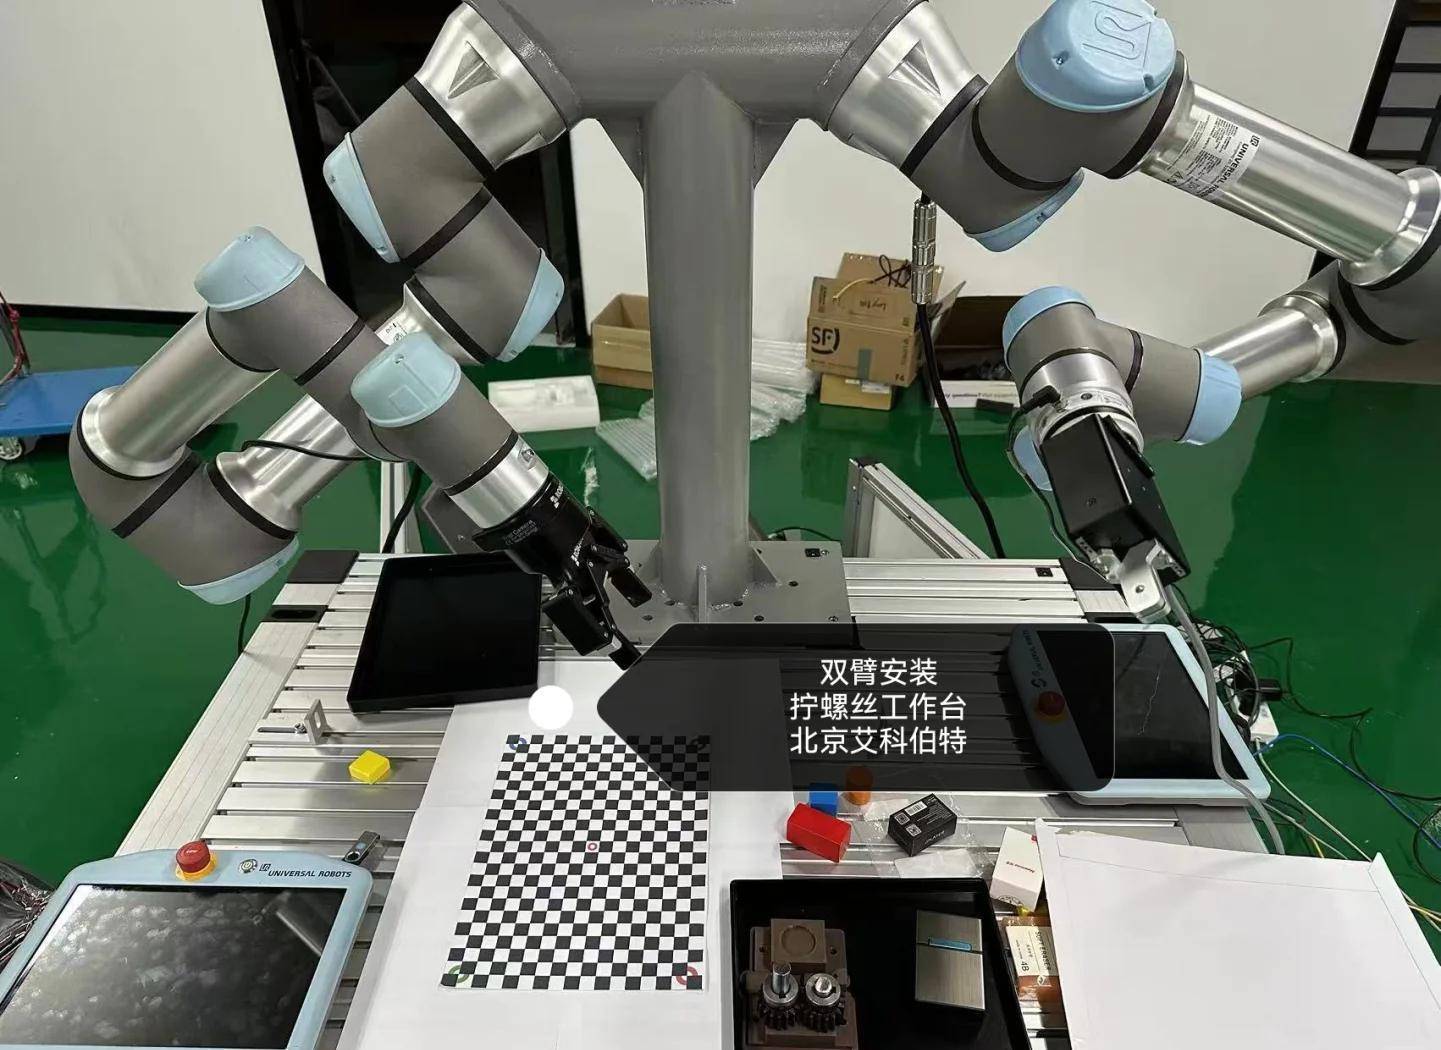
问题不在‘脑’,而在‘手眼脑’之间的那根神经没接通。传统评测只考‘看图说话’:给你一张三维场景图,问‘红球在蓝盒左边还是右边?’——模型秒答。但VA-Bench偏不给图,只放一段成功操作视频,然后把机器人丢进真实环境:视角自己选、信息自己补、动作自己定、抓空了自己改。它得判断‘现在这角度够不够看清瓶底反光?’‘刚才那下夹得偏了,是该微调角度还是重来一次?’——这些没有标准答案的临场决策,才是物理世界的真实门槛。
更现实的是,失败往往发生在最后一厘米。数据显示,前三名模型子任务完成率超65%,但终端成功率腰斩。它们能精准定位瓶子,却在接触前0.5秒误判曲率;能立刻发现抓空(错误发现ED得分73.6%),可修正动作却像蒙眼调音:Qwen3.8-max在线修正OC只有46.7%,Opus-5更是低至27.3%。说白了,现在的AI不是空间智能弱,是‘执行智能’几乎为零——它敢想,不敢动;看得清,调不准;诊断快,动手慢。
这事儿其实挺像我们学骑自行车。光看视频、背口诀,甚至能把平衡原理讲得头头是道,可真跨上车,腿一蹬就歪,手一抖就晃——不是不懂,是身体没记住“3.2毫米”和“0.5秒”这种毫秒级的反馈节奏。机器人也一样,它的“肌肉记忆”压根没被训练过。VA-Bench里那个拧瓶盖任务,人类平均试2.3次就能成功;模型控制的机械臂,平均失败17次才碰巧对上一次螺纹。这不是算力问题,是它从没经历过指尖打滑、金属微震、负载突变这些真实世界的“小脾气”。
有人会说:“加数据不就完了?”但现实很骨感:真实机器人操作数据太贵了。一条高质量双臂协同抓取视频,要标定关节角度、力觉反馈、视觉帧同步、接触点形变……标注成本是ImageNet单张图的200倍以上。OpenAI去年公开的机器人数据集,总共才874段有效轨迹,还全是单臂、固定光照、无遮挡。而工厂流水线上,一个工人换班8小时,手部微动作产生的有效交互数据,够填满三个TB硬盘。
更关键的是,现在的强化学习框架,还在用“奖励函数”当指挥棒。可物理世界哪有什么清晰的+1/-1?瓶子没拧开,是扭矩不够?角度偏了?还是瓶盖本身有毛刺?人类靠触觉+听觉+视觉三路信号交叉验证,AI却只能盯着稀疏的奖励信号干猜。MIT去年实测发现,92%的失败案例里,模型把“夹具轻微打滑”误判成了“目标位姿漂移”,结果越调越错。
所以别急着喊“通用机器人来了”。真正的突破可能不在更大参数,而在更笨的尝试:让AI在仿真里摔一万次,在真机上拧坏一百个瓶盖,在传感器噪声里学会分辨“是线松了”还是“我手抖了”。就像小孩学系鞋带,不是靠理解“绳结拓扑学”,是靠十次打滑、八次勒手、五次被妈妈笑着扶住手——那点“手感”,从来不在代码里,而在一次次真实的卡顿、回弹和再试探中长出来。
盈富优配提示:文章来自网络,不代表本站观点。
股升网配资 生物医药公司扎堆“赶考”港交所 “A+H”上市模式受青睐
兴旺国际投资平台 全国首套 先导智能GW级PEM电解槽(湿膜工艺)自动化组装产线发货
创元网 ETF今日收评 | 巴西ETF涨超4%,港股创新药相关ETF涨超3%